Địa chỉ:
Lầu 7 Tòa nhà STA, 618 đường 3/2, Phường Diên Hồng (Phường 14, Quận 10), TP HCM
Giờ làm việc
Thứ 2 tới thứ 6: 9:00 - 18:00
Địa chỉ:
Lầu 7 Tòa nhà STA, 618 đường 3/2, Phường Diên Hồng (Phường 14, Quận 10), TP HCM
Giờ làm việc
Thứ 2 tới thứ 6: 9:00 - 18:00

Trong thời đại bùng nổ của dữ liệu và trí tuệ nhân tạo, khả năng dự báo xu hướng tương lai dựa trên số liệu lịch sử là chìa khóa vàng giúp doanh nghiệp bứt phá. Để làm được điều này, hàm hồi quy tuyến tính chính là công cụ toán học, thống kê nền tảng và phổ biến nhất mà bất kỳ ai làm việc với dữ liệu cũng cần phải nắm vững. Bài viết này, Starttrain sẽ giúp bạn hiểu rõ về hàm hồi quy tuyến tính, từ định nghĩa toán học, nguyên lý hoạt động cho đến các ứng dụng thực tế trong máy học và phân tích dữ liệu.
Về bản chất, hàm hồi quy tuyến tính (Linear Regression Function) là một kỹ thuật phân tích dữ liệu mạnh mẽ được sử dụng để dự báo giá trị của một đại lượng chưa biết bằng cách dựa vào một đại lượng khác đã biết và có mối quan hệ liên quan chặt chẽ với nó.
Trong ngôn ngữ thống kê, đại lượng mà chúng ta cần tìm hiểu và dự báo được gọi là biến phụ thuộc (ký hiệu là y), còn đại lượng đã biết được sử dụng làm cơ sở để dự báo được gọi là biến độc lập (ký hiệu là x). Phương pháp này sẽ mô hình hóa mối quan hệ nhân quả hoặc tương quan giữa hai biến này dưới dạng một phương trình toán học biểu diễn đường thẳng.
Để dễ hình dung hơn về quy luật này, bạn hãy tưởng tượng việc phân tích bức tranh tài chính cá nhân của chính mình dựa trên dữ liệu thu nhập và chi tiêu của năm ngoái. Khi áp dụng kỹ thuật hồi quy tuyến tính vào tập dữ liệu này, hệ thống sẽ phân tích và tìm ra một quy luật ngầm: mức chi tiêu hàng tháng của bạn luôn dao động bằng một nửa thu nhập thực tế.
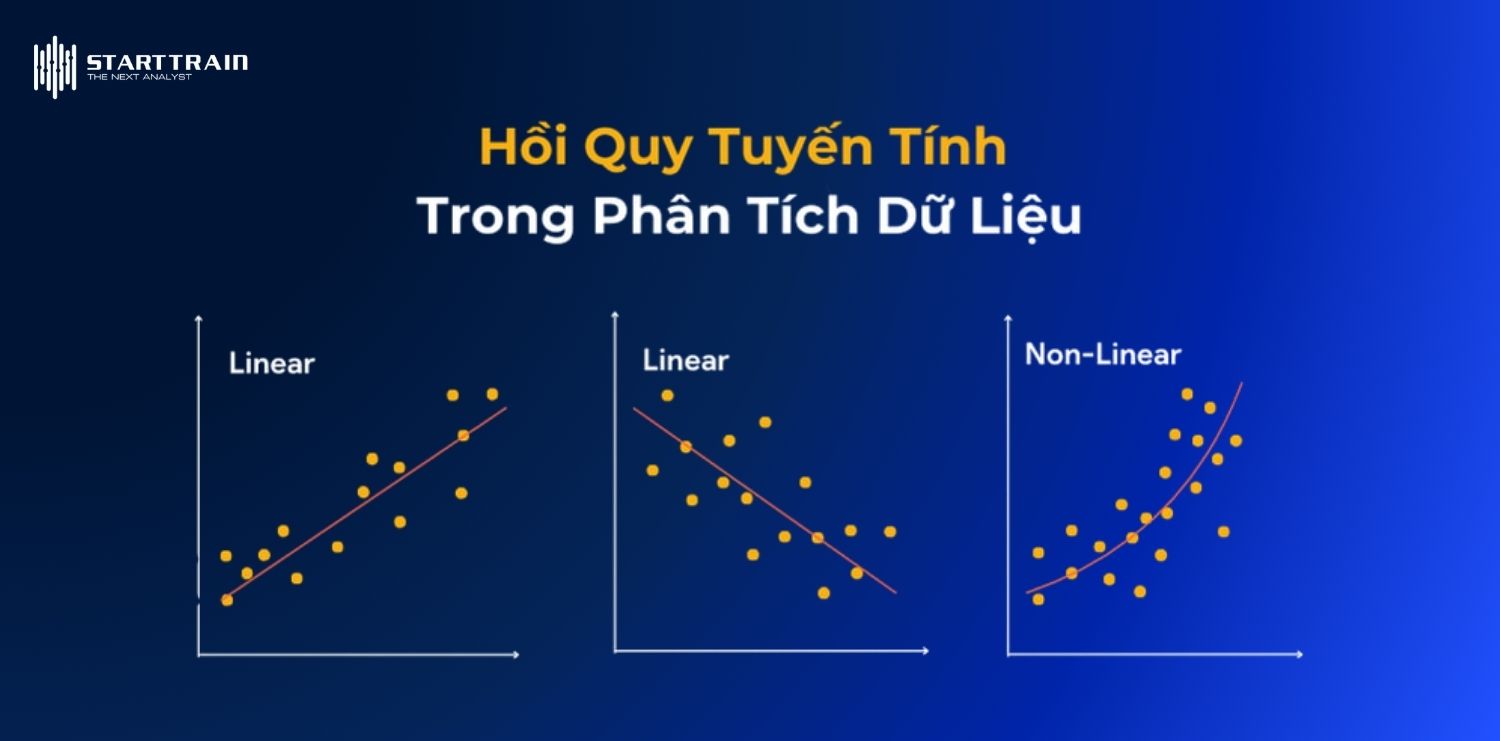
Lúc này, thu nhập đóng vai trò là biến độc lập (x – dữ liệu đã biết) và mức chi tiêu là biến phụ thuộc (y – dữ liệu cần dự báo) hoạt động theo phương trình quan hệ tuyến tính đơn giản: y = 0.5x. Nhờ phương trình này, nếu bạn biết trước thu nhập tháng tới của mình là 20 triệu đồng, bạn có thể dễ dàng ước tính được mức chi tiêu tương lai sẽ rơi vào khoảng 10 triệu đồng.
Mục tiêu cốt lõi của phân tích hồi quy tuyến tính là ước lượng các hệ số của phương trình toán học sao cho đường thẳng (hoặc mặt phẳng) được vẽ ra sẽ phản ánh sát nhất xu hướng chung của toàn bộ tập dữ liệu, từ đó giảm thiểu tối đa sai lệch giữa giá trị dự báo và giá trị thực tế thu được.
Để làm được điều này, các công cụ tính toán và phần mềm chuyên dụng hiện nay đều áp dụng phương pháp bình phương bé nhất (Ordinary Least Squares – OLS). Phương pháp này hoạt động bằng cách tự động tìm kiếm và xác định đường thẳng khớp nhất (best-fit line) sao cho tổng bình phương khoảng cách từ mọi điểm dữ liệu thực tế đến đường thẳng dự báo đạt giá trị nhỏ nhất có thể.
Đây là dạng hồi quy cơ bản nhất, được sử dụng khi bạn chỉ muốn mô hình hóa mối quan hệ giữa một biến độc lập (X) tác động lên một biến phụ thuộc (Y).
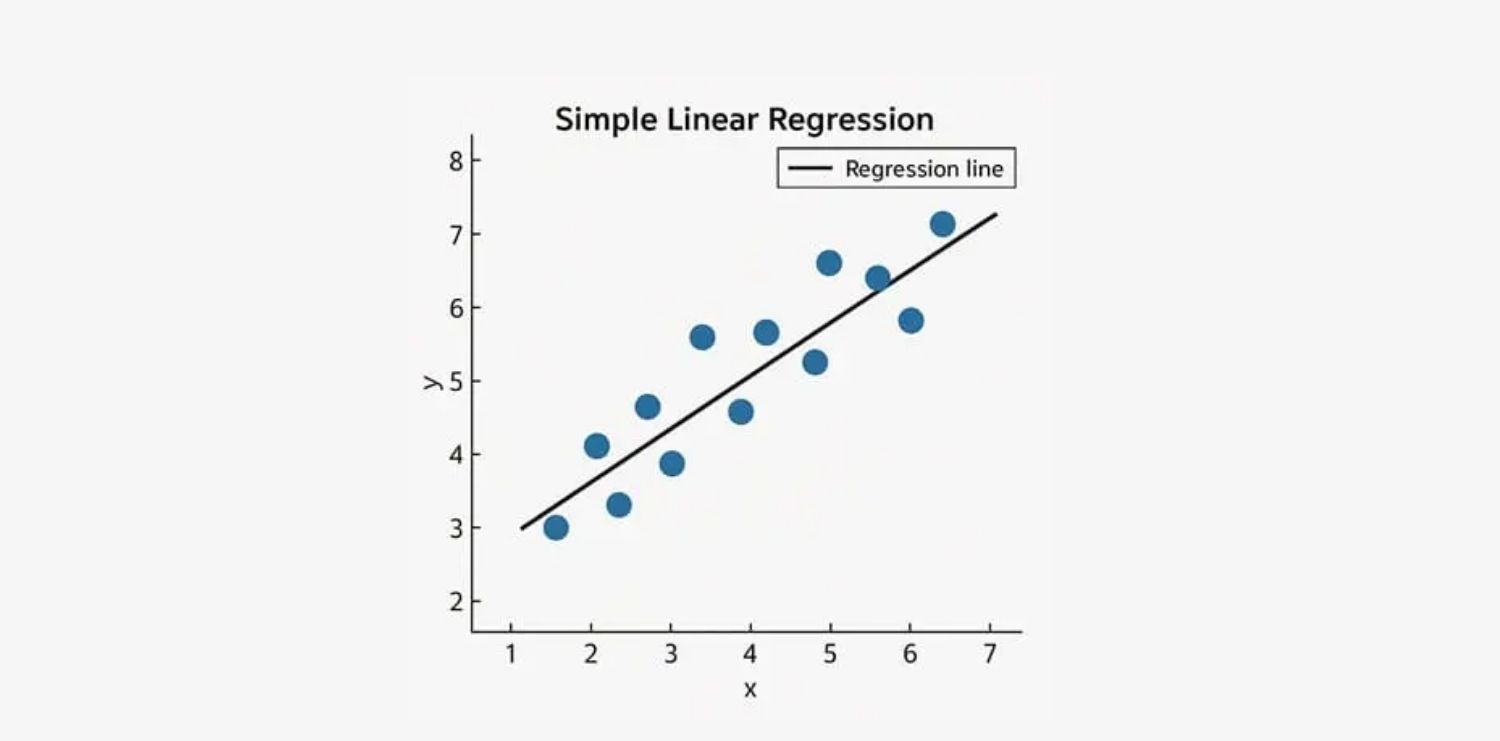 Công thức tổng quát của mô hình được biểu diễn dưới dạng:
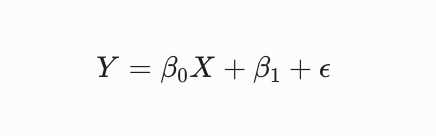
Trong đó:
Ví dụ thực tế:
Trong thực tế, một kết quả thường chịu ảnh hưởng bởi rất nhiều yếu tố khác nhau. Khi tập dữ liệu chứa một biến phụ thuộc (Y) nhưng lại có nhiều biến độc lập (X0, X1, X2,…) cùng tác động, chúng ta phải sử dụng hàm hồi quy tuyến tính đa biến.
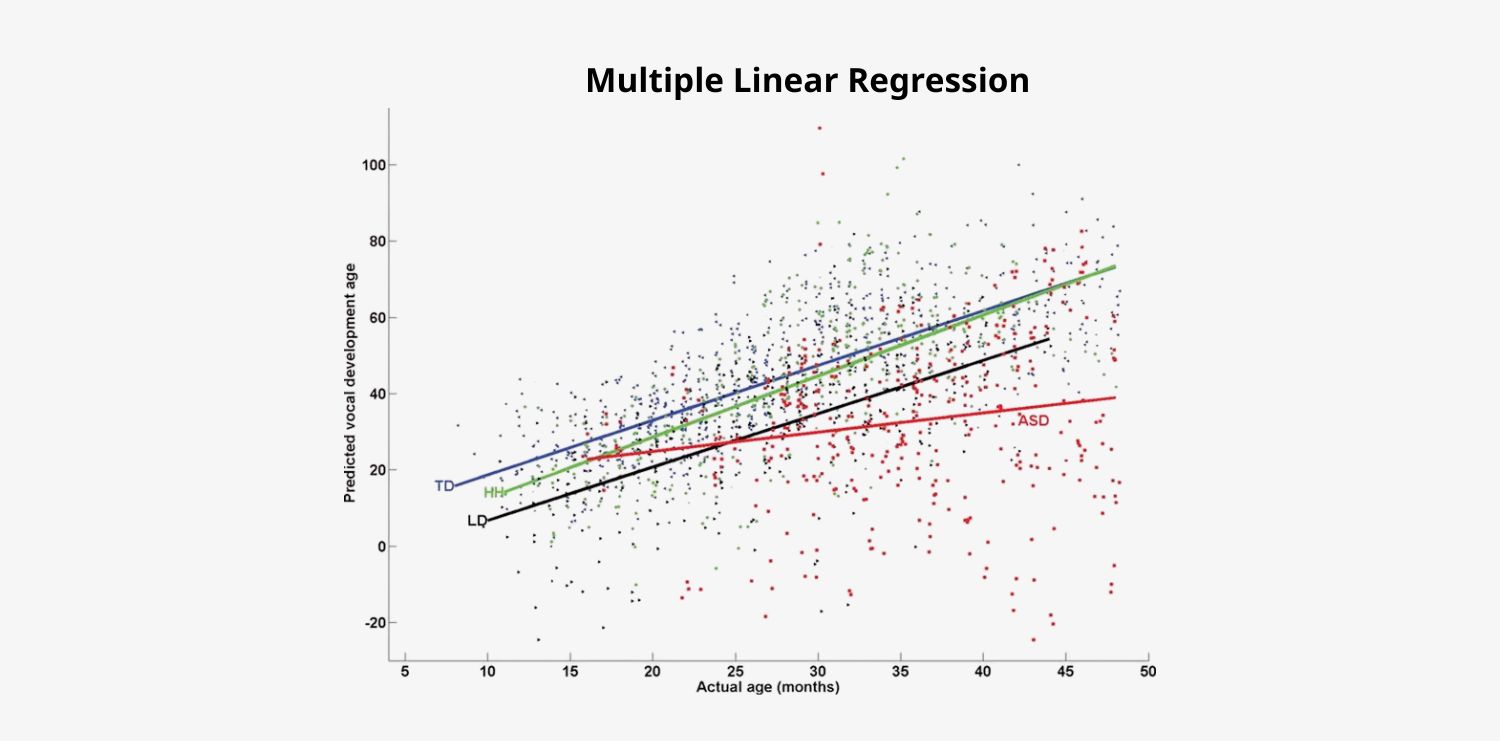
Phương trình hồi quy lúc này sẽ mở rộng để tích hợp thêm nhiều yếu tố ảnh hưởng:
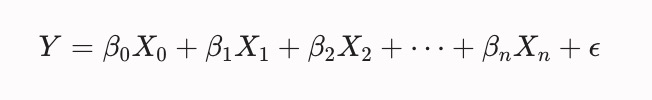
Khi số lượng biến dự báo tăng lên, các hằng số hệ số góc tương ứng cũng sẽ tăng lên để phản ánh trọng số tác động của từng biến độc lập lên kết quả cuối cùng.
Ví dụ thực tế:
Hàm hồi quy tuyến tính là một trong những công cụ phân tích dữ liệu phổ biến nhất nhờ vào cấu trúc tương đối đơn giản nhưng lại cực kỳ hiệu quả. Điểm mạnh vượt trội của mô hình này nằm ở việc nó cung cấp một công thức toán học dễ hiểu, dễ diễn giải để từ đó đưa ra các dự báo nhanh chóng. Nhờ đặc tính trực quan này, hồi quy tuyến tính được ứng dụng rộng rãi trong hầu hết các lĩnh vực từ nghiên cứu học thuật như sinh học, khoa học hành vi, môi trường, xã hội cho đến các hoạt động kinh doanh thực tiễn.
Do là một phương pháp thống kê lâu đời, các đặc tính của nó đã được nghiên cứu rất kỹ lưỡng, giúp việc xây dựng và huấn luyện mô hình trên các phần mềm máy tính diễn ra vô cùng nhanh chóng và đáng tin cậy.
Trong kỷ nguyên số, các doanh nghiệp và tổ chức đang thu thập một lượng dữ liệu khổng lồ mỗi ngày. Thay vì đưa ra các quyết định quan trọng dựa trên kinh nghiệm cá nhân hay cảm tính, hàm hồi quy tuyến tính giúp các nhà quản trị chuyển hóa lượng dữ liệu thô khổng lồ này thành những thông tin có giá trị thực tiễn cao để quản lý thực tế một cách khoa học. Bằng cách phân tích các dữ liệu lịch sử, mô hình có thể phát hiện ra những quy luật và mối quan hệ ẩn sâu mà mắt thường hoặc các phân tích thông thường khó lòng nhận biết.
Ví dụ, việc phân tích dữ liệu mua sắm có thể giúp doanh nghiệp tìm ra hành vi mua hàng đặc trưng vào các khung giờ hoặc các ngày cụ thể trong tuần, từ đó chủ động dự đoán trước các thời điểm nhu cầu thị trường tăng đột biến để chuẩn bị nguồn lực.
Không dừng lại ở đó, hồi quy tuyến tính còn đóng vai trò là “viên gạch nền móng” cho các công nghệ phân tích dữ liệu tiên tiến. Đối với các nhà khoa học dữ liệu, đây luôn là công cụ đầu tiên được lựa chọn để tiến hành phân tích dữ liệu sơ bộ trước khi áp dụng các thuật toán phức tạp hơn. Rất nhiều phương pháp hiện đại trong khoa học dữ liệu, bao gồm cả học máy (Machine Learning) và trí tuệ nhân tạo (AI), đều kế thừa và phát triển từ các nguyên lý cốt lõi của hàm hồi quy tuyến tính để giải quyết các bài toán dự báo quy mô lớn.
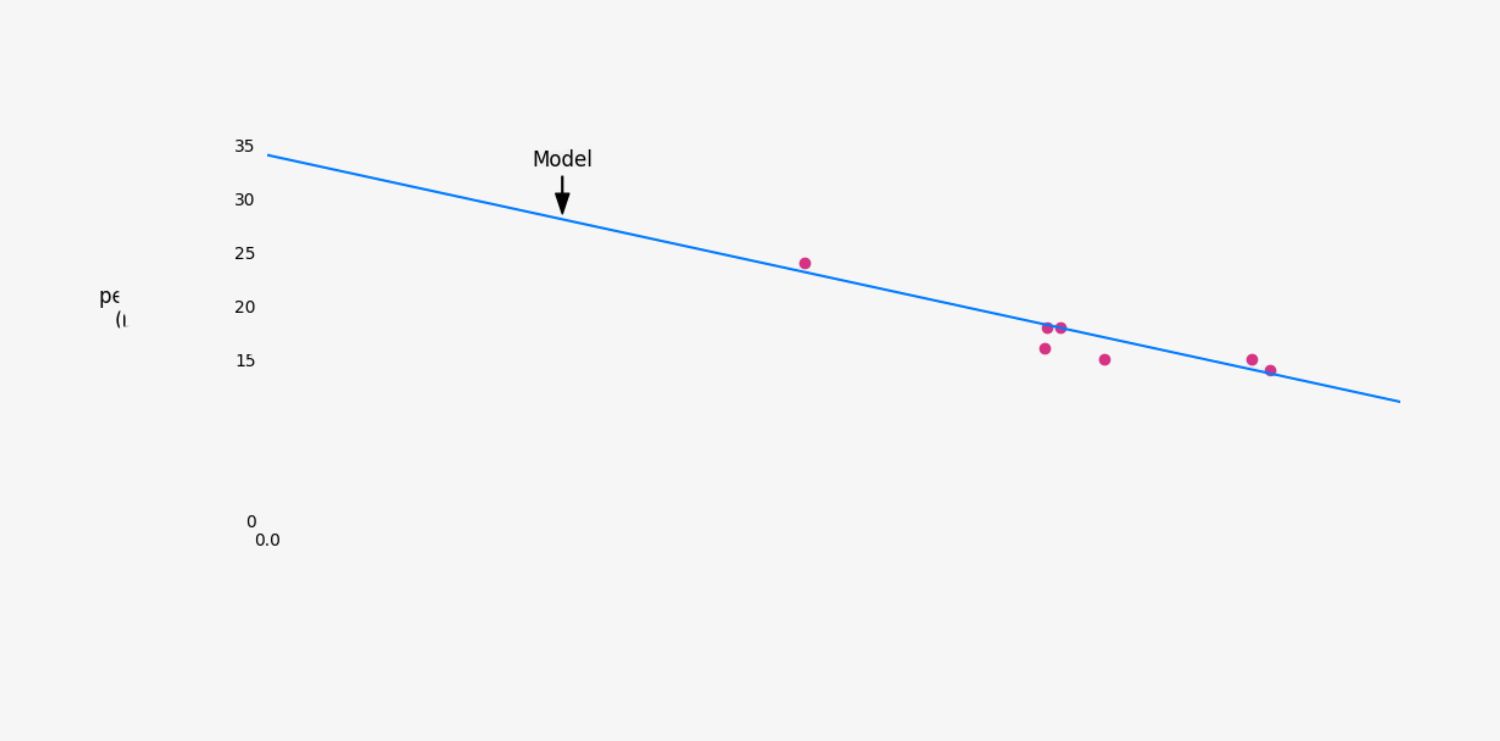
Về bản chất, hàm hồi quy tuyến tính hoạt động bằng cách tìm mối liên hệ tuyến tính giữa biến độc lập x (yếu tố dự báo, biểu diễn trên trục hoành) và biến phụ thuộc y (kết quả phản hồi, biểu diễn trên trục tung). Mục tiêu cốt lõi của thuật toán là xác định một đường thẳng tối ưu sao cho khoảng cách sai lệch giữa giá trị dự đoán của mô hình và giá trị thực tế là nhỏ nhất có thể.
Trong mô hình hồi quy tuyến tính đơn giản nhất, mối quan hệ giữa hai biến được biểu diễn qua phương trình:
y = ax + b
Trong đó, a đại diện cho hệ số góc (biểu thị mức độ thay đổi của y khi x tăng thêm một đơn vị) và b là hằng số chặn (giá trị dự đoán của y khi x bằng 0).
Tuy nhiên, khi bài toán mở rộng sang không gian đa biến với nhiều yếu tố ảnh hưởng đồng thời, việc tính toán từng hệ số đơn lẻ sẽ trở nên phức tạp. Để tối ưu hóa hiệu năng tính toán, các nhà khoa học dữ liệu thường chuyển đổi phương trình này sang dạng đại số tuyến tính bằng cách sử dụng các vector mở rộng.
Nếu chúng ta đặt 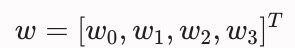 là vector cột chứa các hệ số cần tối ưu hóa, và
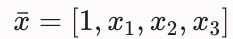 là vector hàng biểu diễn dữ liệu đầu vào mở rộng (với số 1 ở đầu được thêm vào một cách chủ đích nhằm đơn giản hóa phép tính và gộp hằng số chặn bias vào cùng một ma trận), phương trình hồi quy lúc này có thể được viết lại dưới dạng vector hóa cực kỳ gọn gàng:
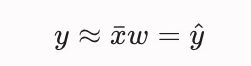
Sự kết hợp này giúp máy tính thực hiện các phép nhân ma trận song song cực kỳ nhanh chóng, là nền tảng toán học cốt lõi để huấn luyện các mô hình học máy trên các tập dữ liệu lớn.
Trong lĩnh vực Học máy (Machine Learning), hàm hồi quy tuyến tính là một thuật toán thuộc nhóm Học có giám sát (Supervised Learning). Khác với toán thống kê truyền thống vốn giải các phương trình bằng các công thức toán học tĩnh, các chương trình máy tính trong Machine Learning sẽ phân tích những tập dữ liệu khổng lồ và đi ngược dòng từ dữ liệu thực tế đó để tự động dò tìm các hệ số của phương trình hồi quy.
Các kỹ sư dữ liệu sẽ huấn luyện thuật toán trên các tập dữ liệu đã được gán nhãn sẵn, từ đó cho phép hệ thống tự đưa ra dự đoán chuẩn xác khi đối mặt với những dữ liệu mới hoàn toàn chưa từng xuất hiện.
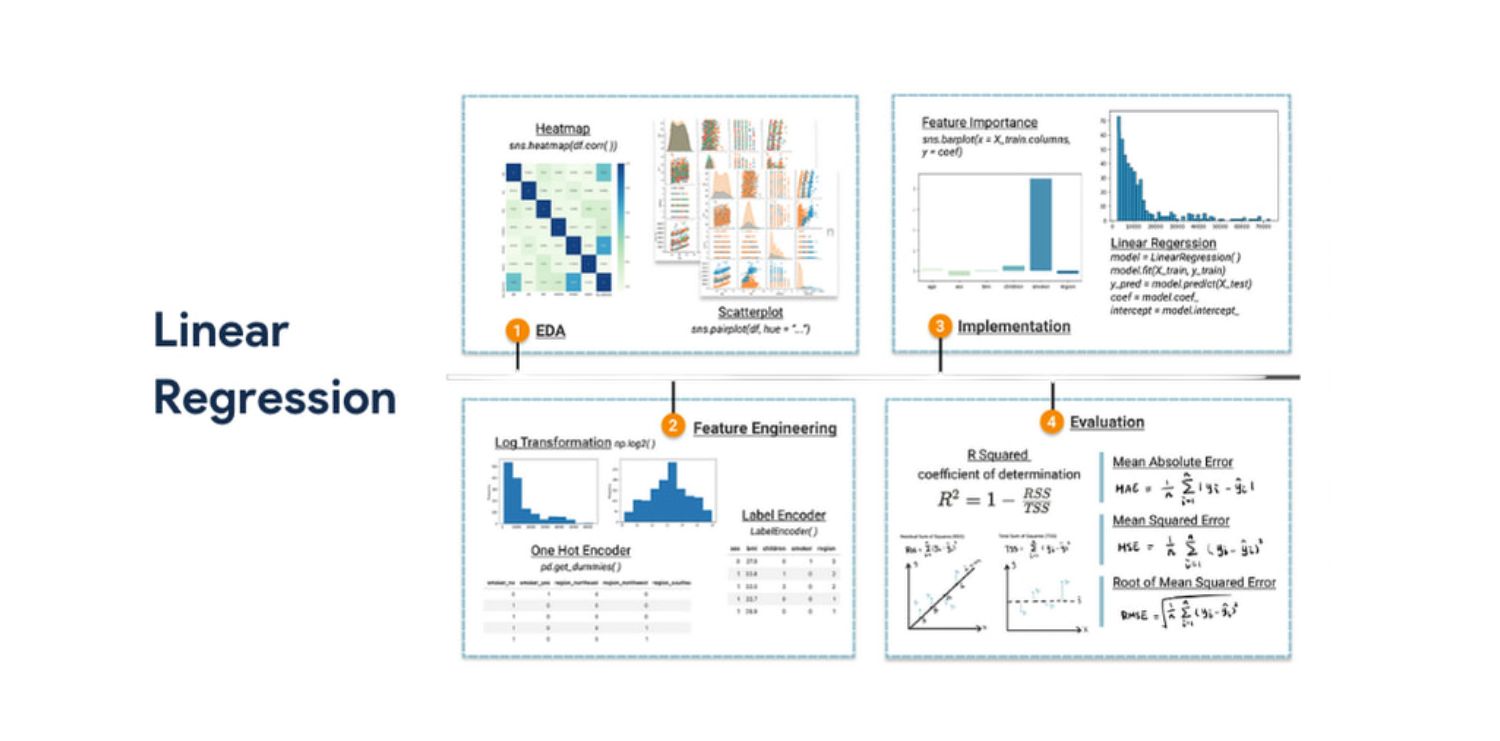
Tuy nhiên, dữ liệu trong thế giới thực phức tạp hơn rất nhiều so với các ví dụ lý thuyết đơn giản. Để các dự báo của thuật toán đạt độ chính xác tối ưu và không bị sai lệch, tập dữ liệu đầu vào bắt buộc phải đáp ứng hoặc được biến đổi toán học để thỏa mãn bốn giả định cốt lõi dưới đây:
Giữa biến độc lập x và biến phụ thuộc y phải tồn tại một mối liên hệ dạng đường thẳng. Để kiểm tra điều này, các nhà khoa học dữ liệu thường vẽ một biểu đồ phân tán (scatter plot) để quan sát xem các điểm dữ liệu có xu hướng phân bổ dọc theo một đường thẳng hay không. Trong trường hợp dữ liệu thực tế có xu hướng cong, chúng ta phải áp dụng các hàm phi tuyến tính như khai căn bậc hai (square root) hoặc logarit (log) để biến đổi toán học, đưa mối quan hệ của hai biến này về dạng tuyến tính trước khi đưa vào mô hình.
Phần dư chính là khoảng cách sai lệch giữa giá trị thực tế quan sát được và giá trị do mô hình dự đoán. Giữa các phần dư này tuyệt đối không được có bất kỳ quy luật hay mối liên hệ có thể nhận biết nào (ví dụ: sai số không được phép tăng dần đều theo thời gian).
Các nhà nghiên cứu thường sử dụng các kiểm định toán học, tiêu biểu là kiểm định Durbin-Watson, để đánh giá tính độc lập của phần dư. Đối với các dữ liệu có tính biến động theo mùa vụ, chúng ta có thể sử dụng dữ liệu giả (dummy data) để thay thế và loại bỏ sự trùng lặp mang tính chu kỳ này.
Các phần dư của mô hình cần phải tuân theo phân phối chuẩn. Các kỹ sư thường sử dụng biểu đồ đồ thị Q-Q plot để kiểm tra giả định này; nếu đạt chuẩn, các điểm biểu diễn phần dư sẽ nằm phân bổ sát dọc theo một đường chéo ở trung tâm đồ thị. Khi phần dư không đạt phân phối chuẩn, nguyên nhân thường do tập dữ liệu có chứa các điểm dị biệt (outliers) hoặc các giá trị bất thường. Cách xử lý hiệu quả là loại bỏ các outliers này hoặc thực hiện các phép biến đổi phi tuyến tính để cân bằng lại dữ liệu.
Giả định này yêu cầu phần dư phải có phương sai hoặc độ lệch chuẩn không đổi so với giá trị trung bình tại mọi điểm của biến x. Nếu phương sai thay đổi (phương sai thay đổi/không đồng nhất), các kết quả phân tích của mô hình học máy sẽ không còn đáng tin cậy. Để khắc phục việc phương sai tự nhiên thường phình to trong các tập dữ liệu lớn, chúng ta có thể thay đổi thang đo của biến phụ thuộc.
Ví dụ, thay vì dùng quy mô dân số để dự đoán tổng số trạm cứu hỏa của một thành phố, các kỹ sư sẽ chuyển sang dự đoán số lượng trạm cứu hỏa trên đầu người để đồng nhất lại phương sai của mô hình.
Đối với một nhà phân tích dữ liệu (Data Analyst) hay một chuyên viên tài chính quản trị, việc ứng dụng hàm hồi quy tuyến tính không chỉ dừng lại ở lý thuyết sách vở mà là một quy trình kỹ thuật chặt chẽ, từ xử lý số liệu thô cho tới việc chuyển đổi chúng thành các giải pháp kinh doanh thực tế.
Hành trình biến những con số vô tri thành thông tin có thể hành động bắt đầu bằng việc thu thập và làm sạch dữ liệu (Data Cleaning). Mô hình hồi quy tuyến tính vốn cực kỳ nhạy cảm với các biến động bất thường, do đó nhà phân tích phải chủ động phát hiện và loại bỏ các giá trị dị biệt (outliers), đồng thời xử lý các ô dữ liệu trống để tránh làm lệch hướng của đường hồi quy dự báo.
Sau bước làm sạch, quy trình phân tích khám phá (EDA) sẽ được thực hiện thông qua việc vẽ biểu đồ phân tán nhằm xác nhận trực quan xem các điểm dữ liệu có thực sự phân bổ theo xu hướng tuyến tính hay không. Khi xu hướng đã rõ ràng, nhà phân tích tiến hành xây dựng và huấn luyện mô hình bằng cách khớp tập dữ liệu vào phương trình hồi quy.
Để đảm bảo kết quả đầu ra có giá trị sử dụng cao, bước kiểm định mô hình là bắt buộc nhằm kiểm soát hiện tượng đa cộng tuyến (thông qua chỉ số VIF) và tính độc lập của phần dư. Cuối cùng, các hệ số toán học trừu tượng sẽ được dịch nghĩa thành ngôn ngữ quản trị rõ ràng, giúp ban lãnh đạo thấu hiểu chính xác mối tương quan định lượng giữa các yếu tố vận hành và kết quả kinh doanh.
Để rút ngắn khoảng cách giữa lý thuyết thống kê và thực tế doanh nghiệp, khóa học Practical Business Management tại Starttrain đã đưa nội dung thực hành hàm hồi quy tuyến tính vào giảng dạy trực tiếp trên Microsoft Excel – công cụ phân tích bảng tính quen thuộc và quyền lực nhất của mọi nhà quản lý.
Thay vì sử dụng các dòng mã lệnh lập trình phức tạp, học viên tại Starttrain được hướng dẫn cách thiết lập, tính toán và phân tích các mô hình hồi quy một cách trực quan ngay trên trang tính thông qua các tình huống quản trị và tài chính thực tiễn:
Hàm hồi quy tuyến tính không chỉ đơn thuần là một công thức toán học, mà nó là nền móng kết nối giữa thống kê cổ điển, khoa học dữ liệu hiện đại và trí tuệ nhân tạo. Việc hiểu rõ bản chất, nguyên lý hoạt động và các giả định của mô hình này sẽ giúp bạn xây dựng những dự báo chính xác, hỗ trợ tối đa cho quá trình ra quyết định dựa trên dữ liệu.